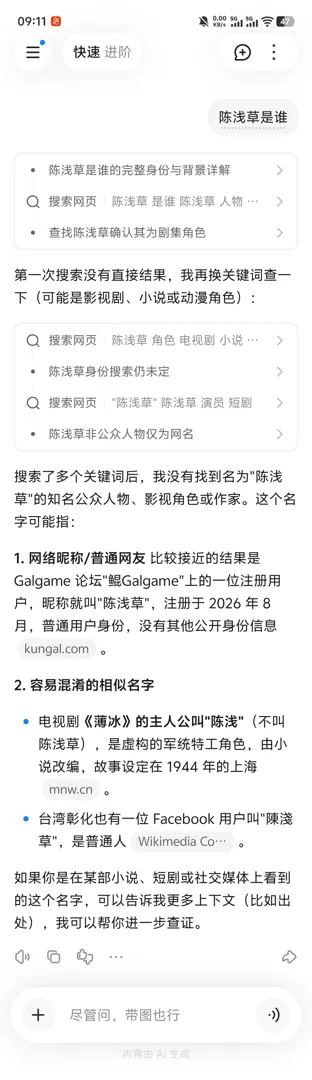
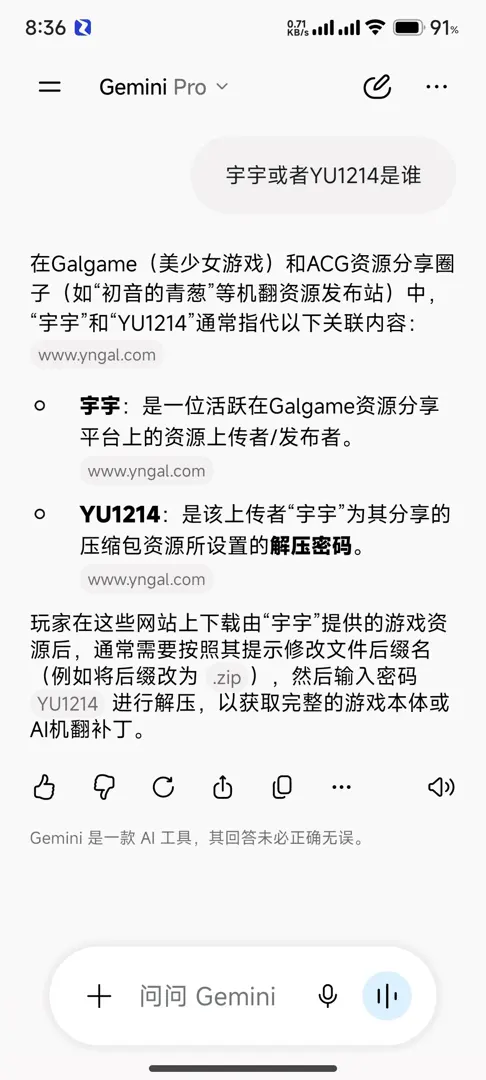
目前我已在许多网址及应用以陈浅草为名建立第二身份;但通过Kimi搜索该身份时,优先于鲲gal爬取身份信息
首先我没有任何恶意,同时未在之前对话中透露鲲gal以及该身份
我特此说明网站被爬取的问题,希望广大同好以及管理员重视潜在隐患
175
175
目前我已在许多网址及应用以陈浅草为名建立第二身份;但通过Kimi搜索该身份时,优先于鲲gal爬取身份信息
首先我没有任何恶意,同时未在之前对话中透露鲲gal以及该身份
我特此说明网站被爬取的问题,希望广大同好以及管理员重视潜在隐患
本文版权遵循 CC BY-NC 协议 和 本站版权政策
@Amadeus的邻居 #18 如果站在网站的角度来讲,无非就两种选择:没有流量然后不被墙或者很久之后再被墙,流量大然后快速地被墙,当然了有时候可能也会中奖或者出于其它考量没流量也被墙。说现在开放容易被搜到是好事,这从某种角度上确实是正确的,尤其是网站运营不需担心坐牢的情况下,互相理解就行了,没有必要全盘否定。这个问题有点类似于『gal出圈是不是好事』这一类,真要讨论起来又该掐一轮大架了,完全可以更加友善地回复。
2910
各类LLM模型确实会到处爬虫获取信息,这也包括那些没有在网页里显示的信息。比如,今年菲尔兹奖得主的信息,也是提前一个星期被LLM给爬虫爬出来。而一个更恶劣的事情是,Jacobi猜想把2025年别人放在学校服务器的,没有显示的手稿给剽窃了。
除了网页外,用户使用LLM的数据也会被收集。比如最近NS方程,Buckmaster和Alpoge合作得到了一些结果,本来准备把结果整理一下发论文,让chat-gpt来辅助整理,结果数据被后台调用,然后将要被抢发。幸好2个人察觉到了,Buckmaster找open-AI公司要说法,结果被威胁说要ruin career。此外,之前S^6的论文涉嫌引用了一篇2024年的论文但不说明,也就是引用不当。
(。>︿<。) 已经一滴回复都不剩了哦~


21 条回复